Generic selectors
Exact matches only
Search in title
Search in content
Post Type Selectors
Statistische assumpties testen en rapporteren in SPSS | Topscriptie

Statistiek in het afstudeeronderzoek: assumpties

Geschreven door: Judy Nijman

Laatst geüpdatet op: 1 oktober 2026

Statistische assumpties testen: zo controleer je of je data klopt

Statistische assumpties testen betekent controleren of je data voldoet aan de voorwaarden van de analyse die je gebruikt, bijvoorbeeld een normale verdeling. Je test ze nadat je data is verzameld en voordat je de resultaten interpreteert. Voldoet je data niet, dan kies je een andere analyse, transformeer je de variabele of motiveer je je keuze in je scriptie.

Statistische assumpties testen is een vast onderdeel van je data analyse. Op deze pagina lees je waarom assumpties belangrijk zijn, hoe je met een boxplot de normaliteit van je data checkt, wat je doet bij een geschonden assumptie en hoe uitgebreid je in je scriptie rapporteert. Ook lees je hoe je een boxplot maakt in SPSS.

Twijfel je of je assumpties of analyses kloppen? 

Waarom zijn statistische assumpties belangrijk?

Statistische assumpties zijn belangrijk, omdat parametrische analyses, zoals Pearson’s correlaties, t testen en multiple lineaire regressies, bijvoorbeeld uitgaan van een normale verdeling. Dit betekent dat de meeste waarden rond het gemiddelde liggen en dat de frequentie afneemt naarmate een waarde verder van het gemiddelde afwijkt. Ook is een normale verdeling symmetrisch: de verdeling ziet er links en rechts van het gemiddelde hetzelfde uit.

Voordat je een parametrische analyse uitvoert, is het daarom slim om eerst te controleren of je variabelen wel normaal verdeeld zijn. Naast normaliteit bestaan er nog andere assumpties, afhankelijk van de analyse die je wilt gebruiken.

Hoe check je normaliteit met een boxplot?

Je checkt normaliteit met een boxplot, een grafiek die in één oogopslag een samenvatting geeft van je data. Je ziet de mediaan, het eerste kwartiel, het derde kwartiel en de spreiding. Vaak worden uitschieters ook apart weergegeven. Daardoor is een boxplot ideaal om snel te beoordelen of je variabele “netjes” verdeeld is en of extreme waarden je analyse kunnen beïnvloeden.

Hoe lees je een boxplot?

In een standaard boxplot zie je meestal dit:

• de lijn in de box is de mediaan
• de onderkant en bovenkant van de box zijn het eerste en derde kwartiel
• de snorren laten zien hoe ver de data nog doorloopt richting lage en hoge waarden
• punten buiten de snorren zijn vaak uitschieters

Let bij interpretatie op twee dingen. Ten eerste: zitten er uitschieters en zijn dat meetfouten of echte extreme cases. Ten tweede: is de box duidelijk scheef of hebben de snorren heel verschillende lengtes, dan kan dat wijzen op een scheve verdeling.

Wat rapporteer je in je scriptie over de boxplots?

Als je boxplots gebruikt als onderdeel van je assumptie checks, kun je kort noteren:

• of er uitschieters zijn en wat je ermee hebt gedaan
• of de verdeling grofweg symmetrisch oogt
• of je op basis hiervan een transformatie of een niet parametrische toets hebt overwogen

Hoe maak je een boxplot in SPSS?

In SPSS kun je boxplots maken via:
Graphs, Chart Builder, Boxplot
of via:
Analyze, Descriptive Statistics, Explore en dan Plots

Daarna kies je je variabele, en eventueel een groepsvariabele om boxplots per groep te vergelijken.

Statistiek in het afstudeeronderzoek: assumpties

Welke statistische assumpties horen bij welke analyse?

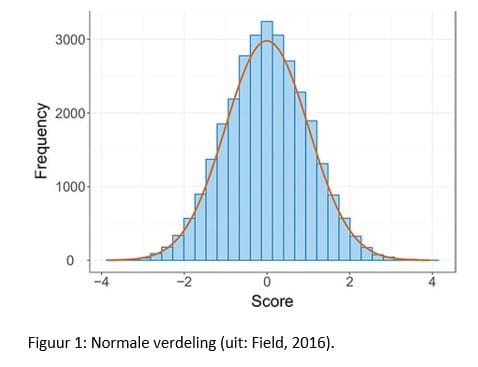
Parametrische analyses, zoals Pearson’s r correlaties, t-testen en multiple lineaire regressies, hebben als aanname (assumptie) dat er sprake is van een normale verdeling. Een normale verdeling wil zeggen dat het grootste deel van de scores rondom het gemiddelde van de variabele liggen en hoe verder weg van het gemiddelde hoe minder vaak de score voorkomt (Figuur 1). Bovendien is er sprake van symmetrie, dezelfde afname van scores zie je zowel links als rechts van het gemiddelde.

Wanneer je dus een parametrische analyse wil gaan uitvoeren, is het verstandig om eerst eens te kijken of de variabelen die je in de berekening wilt stoppen wel normaal verdeeld zijn. Zo zijn er, afhankelijk van de analyse die je wil uitvoeren, nog meer assumpties die je kunt testen voor je de resultaten van je analyse gaat interpreteren.

Elke statistische analyse heeft zijn eigen assumpties

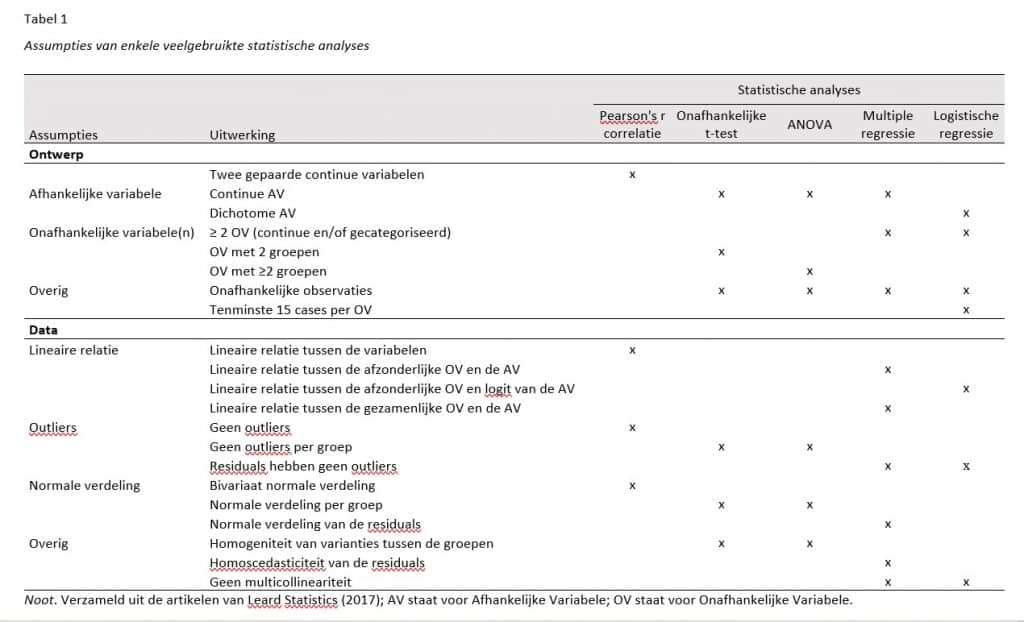
In Tabel 1 hieronder zijn de assumpties van enkele veelgebruikte statistische analyses weergegeven. De assumpties zijn hier ingedeeld in ontwerp-assumpties en data-assumpties. De ontwerp-assumpties heb je zelf grotendeels in de hand en bepaal je tijdens je onderzoeksdesign fase. Wanneer je besluit om de afhankelijke variabele op een dichotome wijze te meten (bijvoorbeeld ziek vs niet-ziek) dan vallen analyses die een continue (interval) afhankelijke variabele vereisen, zoals (multiple) lineaire regressie of ANOVA, direct als opties af. De data-assumpties test je nadat de data verzameld zijn. Je hoopt daarbij dat aan de assumpties van de gekozen statistische analyses wordt voldaan, maar er bestaat een kans dat dat niet het geval is.

Wat doe je bij geschonden statistische assumpties?

Wanneer een of meerdere assumpties in je onderzoek niet blijken te kloppen, kan dit de nauwkeurigheid van je resultaten beïnvloeden. Het is belangrijk om dan na te denken over mogelijke oplossingen. Soms zijn er alternatieve analysemethoden beschikbaar of kun je ervoor kiezen om een variabele te transformeren om de schending te corrigeren. In andere gevallen kun je besluiten de analyse toch uit te voeren, omdat je inschat dat de invloed van de schending beperkt zal zijn. Wat je ook kiest, het is essentieel om in je scriptie duidelijk te vermelden dat een assumptie geschonden is en welke stappen je hebt genomen om de resultaten toch op een correcte manier te interpreteren. Dit toont zorgvuldigheid en transparantie in je onderzoeksproces.

Moet je statistische assumpties testen in je thesisonderzoek?

Ja! Het controleren van assumpties is een essentieel onderdeel van de analysefase. Door dit goed te doen, zorg je ervoor dat je resultaten betrouwbaar zijn en toon je aan dat je jouw statistische methoden doordacht hebt gekozen.

Docenten verwachten vaak dat je deze tests uitvoert en bespreekt. Gelukkig bieden statistische programma’s zoals SPSS de mogelijkheid om verschillende assumpties automatisch te testen. Soms krijg je zelfs gecorrigeerde resultaten als een belangrijke aanname niet blijkt te kloppen. Voor sommige assumpties moet je extra stappen ondernemen, zoals het maken van grafieken of aanvullende tests.

Wil je zeker weten dat je statistische analyses kloppen? Neem de tijd om je assumpties te testen—het is een kleine moeite die veel problemen kan voorkomen!

Hoe uitgebreid rapporteer je over statistische assumpties?

Hoewel ik van harte aanbeveel om de assumpties van elke statistische (hoofd)analyse te testen, is het niet aan te raden om heel uitgebreid verslag te doen van de resultaten van die assumptie-testen. Soms kom ik resultatenhoofdstukken tegen waar het overgrote deel, met tabellen en grafieken, gaat over het testen van de assumpties en pas aan het einde worden, in slechts enkele zinnen, de resultaten van de hoofdanalyses gerapporteerd. Dat is niet verstandig. Jouw onderzoek draait om de resultaten van de hoofdanalyses en die moeten dan ook centraal staan in het hoofdstuk.

Maak je één assumptieparagraaf in je resultatenhoofdstuk?

Persoonlijk ben ik geen fan van het maken van één assumpties paragraaf in het resultatenhoofdstuk. Het kan, wanneer je slechts één univariate statistische analysetechniek gebruikt. Bijvoorbeeld als je alleen maar correlatie-toetsen uitvoert, dan kun je in een assumpties paragraaf melden welke variabelen wel en welke niet normaal verdeeld waren, of ze outliers hadden en of ze onderlinge lineaire relaties hadden. Ook kun je daarin aangeven welke acties je hebt ondernomen wanneer een van die assumpties geschonden bleek.

Maar het komt vaker voor dat studenten meerdere statistische analyses uitvoeren. Dan moeten ook meerdere sets van assumpties worden getest. Wanneer je twee multiple regressies uitvoert, worden de assumpties van normaliteit van de residuals, geen outliers, lineaire verbanden, homoscedasticiteit en geen multicollineariteit ook twee keer getest. Het is dan lastig voor de lezer om te onthouden welke assumpties bij welke analyse geschonden waren. Daarom geef ik er persoonlijk de voorkeur aan om de resultaten van de assumptie-tests bij de rapportage van de desbetreffende statistische analyse te lezen.

Meestal raad ik aan om in de data-analyse paragraaf van de methode-sectie aan te geven dat je de assumpties getest hebt en dat alleen als een schending is gevonden dit bij de desbetreffende analyse gerapporteerd zal worden. Zo laat je zien dat je zorgvuldig met de assumpties van alle analyses bent omgegaan, zonder de lezer te veel af te leiden van de resultaten waar jouw thesis om draait.

Wat als je SPSS resultaten niet significant zijn?

Ook niet-significante resultaten zijn waardevol. In plaats van ze te verdoezelen kun je ze interpreteren:

Leg uit waarom de resultaten mogelijk niet significant zijn.

  Verbind dit aan theorie of methodologische keuzes.

  Beschrijf wat dit betekent voor de huidige kennis.

Voorbeeld: “Hoewel de hypothese niet werd bevestigd, kan dit wijzen op een modererende factor die in vervolgonderzoek onderzocht moet worden.”

Wil jij hulp bij SPSS of een ander statistisch programma zoals Stata, MPlus, Python, JAMOVI, JASP & R?

Veelgestelde vragen

Statistische assumpties zijn de voorwaarden waaraan je data moet voldoen, zodat de formules van een analyse betrouwbare resultaten geven. Ze zijn onder te verdelen in ontwerpassumpties, die je vooraf bepaalt, en data assumpties, die je test nadat je data is verzameld. Parametrische analyses zoals Pearson’s correlaties, t testen en multiple lineaire regressies gaan bijvoorbeeld uit van een normale verdeling. Elke analyse heeft daarnaast eigen assumpties.

Je test normaliteit in SPSS visueel met een boxplot, via Graphs, Chart Builder, Boxplot of via Analyze, Descriptive Statistics, Explore en dan Plots. Een boxplot laat de mediaan, de kwartielen, de spreiding en uitschieters zien. Een scheve box of snorren van verschillende lengte kunnen wijzen op een scheve verdeling. Via Explore kun je ook normaliteitstoetsen opvragen. Kies je variabele en eventueel een groepsvariabele om per groep te vergelijken.

Je kiest een alternatieve analysemethode, transformeert de variabele of voert de analyse toch uit als je inschat dat de invloed van de schending beperkt is. Een niet parametrische toets is een gangbaar alternatief wanneer je data niet normaal verdeeld is. Wat je ook kiest, je vermeldt in je scriptie dat de assumptie geschonden is en welke stappen je hebt genomen. Zo toon je zorgvuldigheid en transparantie.

Rapporteer kort over assumpties. Je onderzoek draait om de resultaten van de hoofdanalyses en die staan centraal in het hoofdstuk. Vermeld in de methodesectie dat je de assumpties hebt getest en rapporteer een schending bij de desbetreffende analyse. Zo hoeft de lezer niet te onthouden welke assumptie bij welke analyse geschonden was.

Bij een multiple regressie test je de normaliteit van de residuals, de afwezigheid van outliers, lineaire verbanden, homoscedasticiteit en de afwezigheid van multicollineariteit. Voer je twee multiple regressies uit, dan test je al deze assumpties twee keer. Een overzicht van de assumpties van gangbare analyses staat in Tabel 1, bij het kopje over assumpties per analyse.

Ja, een begeleider van Topscriptie helpt je met hulp bij SPSS en met andere statistische programma’s zoals Stata, MPlus, Python, JAMOVI, JASP en R. Je krijgt hulp bij het kiezen van de juiste analyse, het testen van assumpties en het interpreteren van je resultaten. Jij blijft zelf verantwoordelijk voor je onderzoek, de begeleider denkt mee en geeft feedback. Je begint met een gratis en vrijblijvend adviesgesprek.

Gratis intakegesprek

Een intakegesprek is altijd geheel vrijblijvend, we geven je graag meer persoonlijke informatie en een advies op maat, zodat je vooraf een goed beeld hebt bij wat we voor jou kunnen betekenen.

    © Copyright 2026 Topscriptie
    4.8